Python3 エンジニア認定データ分析試験 の学習-pandas-の知識と実務での活用 (前編)~ファネル分析で学ぶ離脱率分析入門~
はじめに
皆さま、こんにちは。グローバルウェイのOです。
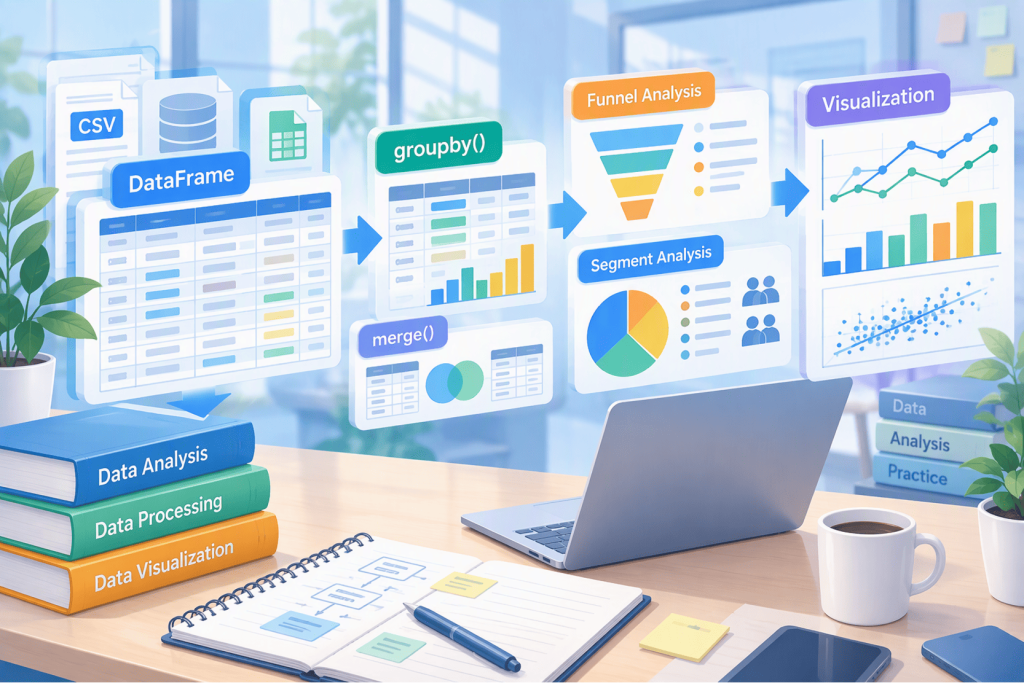
最近、私は業務目標の一つとして資格取得を設定したことがきっかけで、Python3エンジニア認定データ分析試験の学習を始めました。学習を進める中で、試験範囲として登場する pandas の知識が、実務のデータ分析や集計処理とも意外に結び付くことに気付きました。試験範囲には、pandas、NumPy、Matplotlibといったデータ分析ライブラリが含まれており、DataFrameの操作やデータ集計、グラフ作成などの基礎を学ぶことができます。
学習を始めた当初、これらについて「この知識は実務でどのように使われるのだろうか」という疑問を持つようになりました。
試験学習では売上データやサンプルデータを使った集計処理が登場します。groupbyを使った分類集計や欠損値処理、グラフの描画など、一見すると分析担当者向けの知識のようにも見えます。
私自身、普段の業務ではDjangoを利用したAPI開発やデータベース周辺の開発に携わることが多いため、正直なところ学習を始めた頃は「実務とのつながり」を強く実感できていませんでした。
しかし、学習を進めるにつれ、試験で学ぶ内容は単なる資格取得のための知識ではなく、サービス改善やユーザー行動分析の基礎にもつながることに気付きました。
その代表例が今回紹介する「ファネル分析」です。
本記事では、Python3エンジニア認定データ分析試験の学習内容とファネル分析を結び付けながら、実務でどのように活用できるのかを紹介したいと思います。
この記事は以下の方を対象としています。
★5 Djangoの開発経験が3年以上。
★4 Djangoの開発経験が1年以上。
★3 Webサイト開発経験あり。これからDjangoを学習します。
★2 Python 初級者。簡単なプログラムコードが書けます。
★1 プログラミング未経験。
試験勉強中に感じた疑問
試験学習では次のようなコードが頻繁に登場します。
Python
df.groupby("page")["user_id"].nunique()
試験対策としては、「groupbyはデータをグループ化して集計する機能」と覚えれば十分です。
しかし、学習を始めた頃の私は、「この知識をどこで使うのだろう」と感じていました。
業務ではデータベースに対してSQLを書くこともありますし、監視ツールやBIツールを利用する場面もあります。
そのため、
- DataFrame
- groupby
- merge
といった機能が実際の業務とどのように結び付くのか、なかなかイメージできませんでした。
ところが、ユーザー行動分析という視点で考えるようになってからこれらの見方が変わり、理解も深まりました。
実際のサービス運営では、
- どのページが利用されているのか
- どの機能がよく使われているのか
- どこで離脱しているのか
- どのユーザー層が利用しているのか
といった課題に向き合う必要があります。
そして、それらを調べるための第一歩となるのが集計処理です。
つまり試験で学ぶgroupbyは、実務では課題発見の入口として利用されているのです。
ファネル分析とは何か
ファネル(Funnel)とは「漏斗」を意味します。
ECサイトなどでは、多くのユーザーがサイトを訪問する一方で、購入まで進むユーザーは徐々に減少していきます。
その様子が漏斗の形に似ていることから、ファネル分析と呼ばれています。 仮に以下のようなデータがあったとします。
| ページ | ユーザー数 |
| TOP | 10,000 |
| LIST | 8,000 |
| DETAIL | 5,000 |
| CART | 1,200 |
| BUY | 800 |
この場合、商品詳細ページからカート画面への遷移で大きくユーザーが減少しています。
この数字を見たとき、
「商品詳細ページ周辺に改善の余地があるのではないか」
という仮説を立てることができます。
これがファネル分析の基本的な考え方です。
重要なのは、問題の原因を断定することではありません。
問題が起きていそうな場所を発見し、改善のための仮説を作ることです。
なぜCVRだけでは足りないのか
サービス改善ではCVR(コンバージョン率)がよく利用されます。
例えば、
- 訪問者数:10,000人
- 購入者数:300人
であれば、CVRは3%となります。もちろん重要な指標です。
しかし、CVRだけでは改善箇所を特定することはできません。
例えば、
- 商品一覧ページに問題があるのか
- 商品詳細ページに問題があるのか
- カート画面に問題があるのか
は判断できません。CVRは結果を示す指標です。
一方でファネル分析は、その結果に至るまでの過程を可視化します。
結果だけを見るのではなく、「なぜその結果になったのか」を考えることがサービス改善では重要になります。
pandasが活躍する場面
ここで、試験でも学習するpandasの出番です。
実務ではアクセスログや操作ログをDataFrameとして扱うことがあります。
ここでは、各ページをファネルの各段階として単純化し、ページ別の利用人数を集計してみます。
例えばページ別到達人数を集計する場合は次のようなコードになります。
funnel = (
    df.groupby("page")
      ["user_id"]
      .nunique()
)
試験学習でもよく目にする処理ですが、実務でもよく利用される処理です。
実際には、
- ページ別利用人数
- 商品別購入数
- 機能別利用回数
- 流入元別利用人数
- 会員種別利用状況
など、さまざまな集計が行われます。
学習当初は、「groupbyは暗記項目のひとつ」という印象しかありませんでした。
しかし、分析を学ぶにつれて「まずgroupbyで現状を把握する」という場面が非常に多いことを知りました。 今では試験範囲というより、データ分析の基本ツールという印象を持っています。
離脱率は原因ではなくヒント
仮に次のようなファネルだったとします。
| ページ | 人数 |
| TOP | 10,000 |
| LIST | 8,000 |
| DETAIL | 5,000 |
| CART | 1,200 |
| BUY | 800 |
DETAILからCARTへの離脱率は76%になります。
数字だけを見ると、「商品詳細ページが悪い」と思ってしまいそうです。
しかし実際には、
- スマートフォンだけ表示崩れが発生している
- ボタンが見つけにくい
- 表示速度が遅い
- 商品説明が不足している
など、様々な可能性が考えられます。
つまり離脱率は原因そのものではありません。
原因を探すための手掛かりです。
分析初心者が陥りやすいミスとして、
「数字だけ見て結論を出してしまう」ことがあります。
しかし、本当に重要なのは数字の背景です。
データは事実を示してくれますが、理由までは教えてくれません。
だからこそ分析者は数字から仮説を作り、その仮説を検証していく必要があります。
可視化の重要性
Python3エンジニア認定データ分析試験ではMatplotlibも学習します。
学習中は、「グラフ作成機能」くらいの認識かもしれませんが、
実務では非常に重要な役割を持っています。
表形式の数値だけを見ても、傾向を直感的に把握することは難しい場合があります。
一方で棒グラフにすると、「どこでユーザーが大きく減少しているのか」が一目で分かります。
また分析結果をチームへ共有する際にも、グラフは非常に有効です。
分析担当者だけが理解していても意味はありません。
関係者全員が同じ課題認識を持てることが重要です。
そのため、データ分析では集計と同じくらい可視化も重要な技術だと感じています。
まとめ
今回改めて感じたのは、Python3エンジニア認定データ分析試験で学ぶ内容は想像以上に実務と結び付いているということです。
DataFrameやgroupbyは単なる試験範囲の知識ではありません。
ユーザー行動を把握し、課題を発見し、サービス改善につなげるためにも活用できるものです。
私自身も学習を始めた頃は、「実際にどのような場面で使うのか」というのを深く考えていませんでした。
しかし、ファネル分析という具体例を考えながら学習することで、試験勉強を実務に生かしていけるのではないかと感じています。
次回は、
- セグメント分析
- デバイス分析
- コホート分析
を題材に、
「どこで離脱したのか」から一歩進んで、「なぜ離脱したのか」を深掘りしていきたいと思います。